O KEDA no EKS resolve um problema que o HPA sozinho não resolve bem: escalar pelo trabalho que está esperando, e não pelo esforço de quem já está trabalhando. Com o KEDA, a quantidade de mensagens numa fila SQS decide quantos pods rodam. Fila vazia, nenhum pod. Fila cheia, os pods sobem, e o Karpenter cria os nós para eles.
Este é o décimo primeiro artigo da série artigos-eks. Ele junta duas peças que já apareceram aqui: o EKS Pod Identity, que dá permissão de AWS sem access key, e o Karpenter, que escala os nós. O KEDA entra no meio e escala os pods. Tudo foi executado num laboratório real, com 1.000 mensagens na fila, e destruído no fim.
Segurança: os comandos deste guia usam o perfil do AWS CLI para autenticar. Nunca coloque access keys no código, no manifesto ou em .tfvars versionado; prefira aws sso login ou um perfil com credenciais temporárias. Dentro do cluster, nenhum pod usa chave: todos recebem credenciais pelo Pod Identity.
Sumário
- Pré-requisitos
- Por que KEDA no EKS, e não só o HPA
- A arquitetura
- O módulo do KEDA com Terraform
- Pod Identity para o KEDA ler a fila
- A fila SQS e o consumidor
- TriggerAuthentication e ScaledObject
- terraform apply e o cluster no ar
- Testando a escala com 1.000 mensagens
- O que o laboratório ensinou
- Custos e limpeza
- Conclusão
- Referências oficiais
Pré-requisitos
AWS CLI v2 autenticado, Terraform >= 1.5 e kubectl. As versões usadas no laboratório:
- Kubernetes 1.36 no EKS;
- KEDA 2.21.0 (chart
kedacore/keda2.21.0); - Karpenter 1.13.1, como no artigo do Karpenter;
- providers
hashicorp/aws ~> 6.0ehashicorp/helm ~> 3.0.
O cluster fica na 1.36 de propósito. O artigo anterior da série usou a 1.37, mas o KEDA 2.21 é testado do Kubernetes 1.34 ao 1.36. Antes de subir a versão do cluster, confira a matriz de compatibilidade de cada controller instalado nele. A 1.36 tem suporte padrão no EKS até agosto de 2027.
Por que KEDA no EKS, e não só o HPA
O HPA escala por CPU e memória. Para uma API, isso funciona: mais requisições geram mais CPU. Para um consumidor de fila, a CPU é um sinal atrasado. Mil mensagens podem estar esperando enquanto os pods existentes trabalham tranquilos, sem pico de CPU. O HPA não vê a fila, então não sobe ninguém.
O KEDA olha a causa. Ele lê uma métrica externa, aqui a profundidade da fila SQS, e entrega esse número ao HPA. Na prática, você declara um ScaledObject e o KEDA cria e gerencia o HPA por você. Ele acrescenta duas coisas que o HPA não faz:
- Scale-to-zero: o HPA tem no mínimo 1 réplica. O KEDA desliga o deployment quando não há trabalho e o religa quando a primeira mensagem chega.
- Dezenas de fontes: SQS, Kafka, CloudWatch, Prometheus, cron e muitas outras, todas com o mesmo modelo de objeto.
Com scale-to-zero nos pods, o Karpenter consegue tirar os nós vazios. Sem trabalho, o cluster volta ao tamanho mínimo, e a conta acompanha.
A arquitetura
O cluster é o mesmo do artigo do Karpenter. Um node group pequeno e fixo, chamado system, roda os controllers: o KEDA e o Karpenter. Os pods da aplicação vão para nós que o Karpenter cria sob demanda, nas subnets privadas.
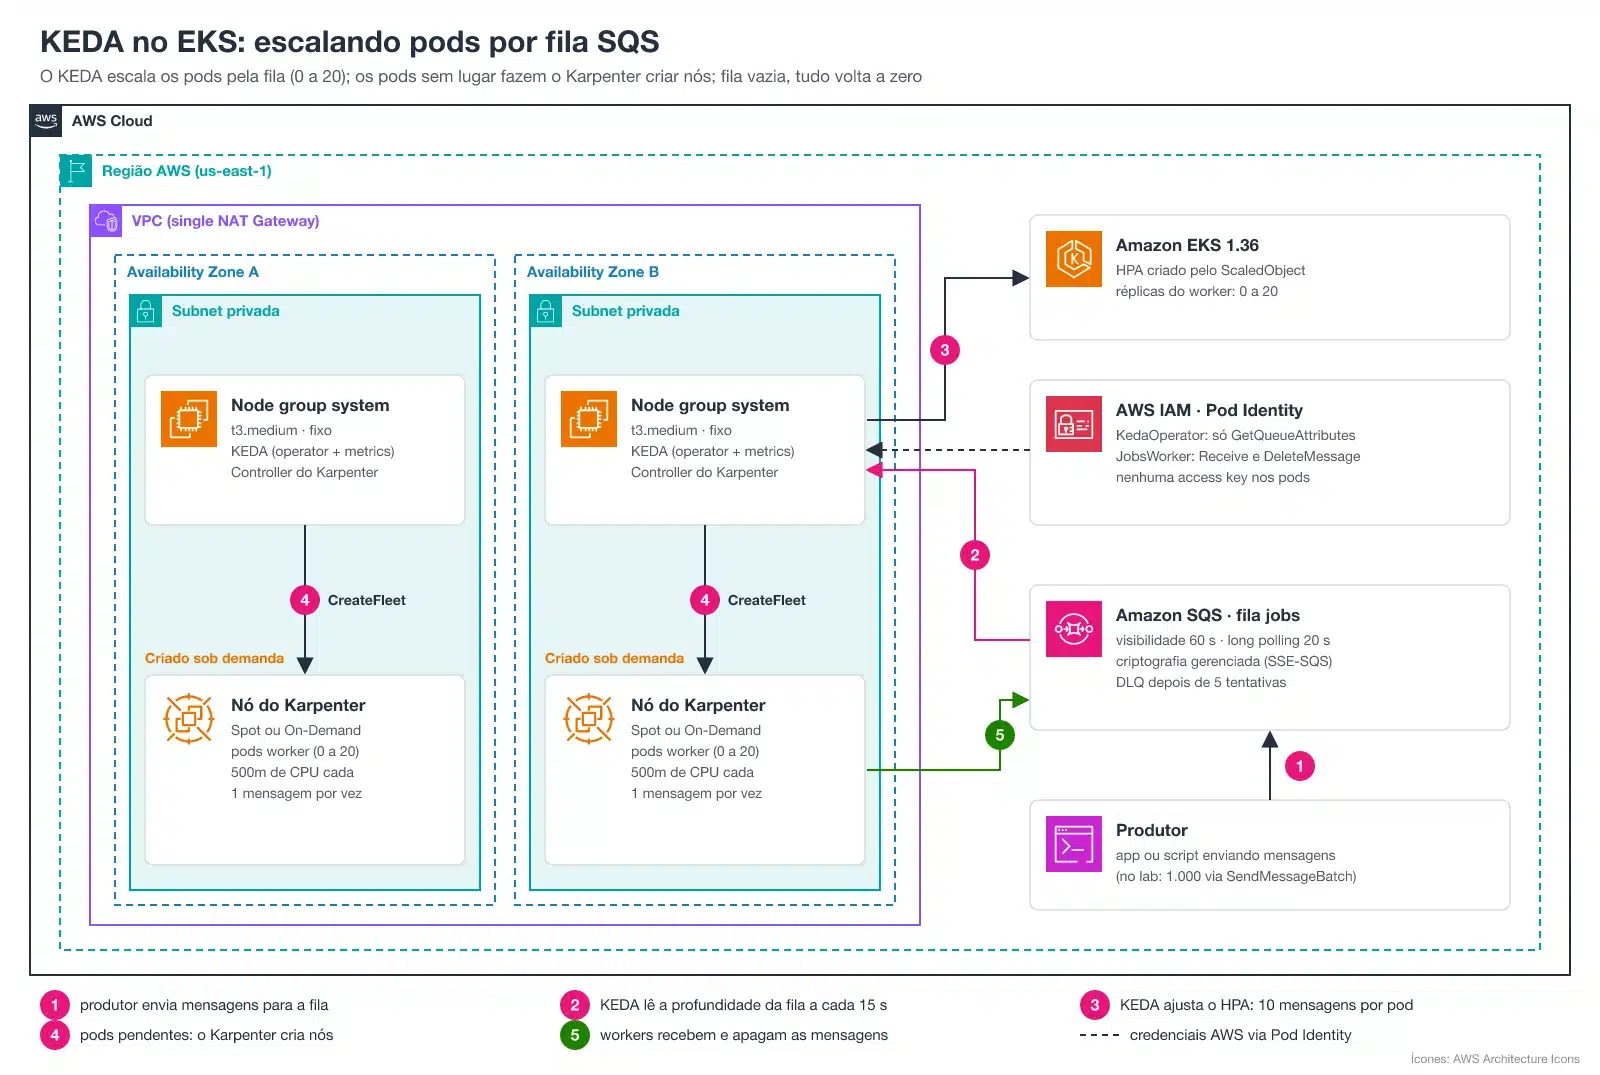
O caminho de uma mensagem segue a numeração do desenho. O produtor envia para a fila. O KEDA lê a profundidade a cada 15 segundos e ajusta o HPA, com a meta de 10 mensagens por pod. Os pods que não cabem ficam pendentes, e o Karpenter cria nós para eles. Cada pod recebe uma mensagem, processa e apaga.
O módulo do KEDA com Terraform
O KEDA ganhou um módulo próprio na série, o terraform-eks-keda-modules. Ele instala o chart oficial no namespace keda e, quando recebe filas, cria a role do operator via Pod Identity. O ambiente do artigo só chama o módulo:
module "keda" {
  source = "../../terraform-eks-keda-modules"

  cluster_name   = module.eks.name
  chart_version  = var.keda_chart_version   # "2.21.0"
  sqs_queue_arns = [aws_sqs_queue.jobs.arn]
  node_selector  = { "node-role" = "system" }

  depends_on = [module.addons]
}
O node_selector vale para os três componentes do chart: operator, metrics server e webhooks. Assim o KEDA fica nos nós fixos, longe dos nós que ele próprio faz o Karpenter criar e remover. Dentro do módulo, o helm_release é curto:
resource "helm_release" "this" {
  name             = "keda"
  repository       = "https://kedacore.github.io/charts"
  chart            = "keda"
  version          = var.chart_version
  namespace        = var.namespace
  create_namespace = true

  values = [yamlencode({
    nodeSelector = var.node_selector
    operator     = { replicaCount = var.operator_replicas }
  })]

  # a associação do Pod Identity precisa existir antes de o pod do operator nascer
  depends_on = [module.pod_identity]
}
Pod Identity para o KEDA ler a fila
Quem lê a fila é o operator do KEDA, não o pod da aplicação. Então a permissão de leitura fica numa role ligada à service account keda-operator, com o módulo de Pod Identity da série. A política só permite consultar os atributos da fila, que é o que o scaler usa para contar mensagens:
locals {
  operator_policy_json = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Sid      = "ReadQueueDepth"
      Effect   = "Allow"
      Action   = ["sqs:GetQueueAttributes", "sqs:GetQueueUrl"]
      Resource = var.sqs_queue_arns
    }]
  })
}

module "pod_identity" {
  source = "../terraform-eks-pod-identity-modules"
  count  = length(var.sqs_queue_arns) > 0 ? 1 : 0

  cluster_name = var.cluster_name
  role_name    = "KedaOperator-${var.cluster_name}"
  service_accounts = [
    { namespace = var.namespace, name = "keda-operator" },
  ]
  inline_policy_json = local.operator_policy_json
}
Um detalhe de Terraform apareceu aqui. A primeira versão montava a política com um data "aws_iam_policy_document". Como o módulo é chamado com depends_on, o Terraform só lê esse data source no apply. O count do módulo de Pod Identity, que depende de a política existir, ficava desconhecido, e o plan falhava com Invalid count argument. Com jsonencode, o Terraform sabe já no plan que o resultado nunca é nulo.
A documentação do KEDA descreve a autenticação na AWS pelo IRSA, com anotação na service account. Ela não fala do EKS Pod Identity. Olhando o código da versão 2.21.0, com o provider aws e sem roleArn, o KEDA usa a cadeia padrão de credenciais do AWS SDK, e essa cadeia já reconhece o Pod Identity. O laboratório confirmou: o operator recebeu as variáveis AWS_CONTAINER_CREDENTIALS_FULL_URI e AWS_CONTAINER_AUTHORIZATION_TOKEN_FILE, sem nenhuma anotação.
A fila SQS e o consumidor
A fila de trabalho tem uma DLQ. Uma mensagem que falha cinco vezes vai para lá, em vez de voltar à fila para sempre e manter o KEDA escalando por causa dela:
resource "aws_sqs_queue" "jobs_dlq" {
  name                      = "jobs-dlq-${var.cluster_name}"
  message_retention_seconds = 1209600
  sqs_managed_sse_enabled   = true
}

resource "aws_sqs_queue" "jobs" {
  name                       = "jobs-${var.cluster_name}"
  visibility_timeout_seconds = 60
  receive_wait_time_seconds  = 20
  sqs_managed_sse_enabled    = true

  redrive_policy = jsonencode({
    deadLetterTargetArn = aws_sqs_queue.jobs_dlq.arn
    maxReceiveCount     = 5
  })
}
O consumidor tem a própria role, ligada à service account jobs/worker, com permissão de receber e apagar mensagens só dessa fila. O exemplo usa a imagem oficial do AWS CLI num loop: recebe uma mensagem, simula 5 segundos de trabalho e apaga. Cada pod pede 500m de CPU e só pode rodar em nós do Karpenter:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: worker
  namespace: jobs
spec:
  replicas: 0 # quem decide é o KEDA
  selector:
    matchLabels:
      app: worker
  template:
    metadata:
      labels:
        app: worker
    spec:
      serviceAccountName: worker
      nodeSelector:
        karpenter.sh/nodepool: default
      terminationGracePeriodSeconds: 60
      containers:
        - name: worker
          image: public.ecr.aws/aws-cli/aws-cli:2.38.6
          command: ["/bin/bash", "-c"]
          args:
            - |
              while true; do
                MSG=$(aws sqs receive-message --queue-url "$QUEUE_URL" \
                  --max-number-of-messages 1 --wait-time-seconds 20 \
                  --query 'Messages[0].[ReceiptHandle,Body]' --output text)
                if [ -n "$MSG" ] && [ "$MSG" != "None" ]; then
                  HANDLE=$(echo "$MSG" | cut -f1)
                  sleep "$WORK_SECONDS" # simula o processamento
                  aws sqs delete-message --queue-url "$QUEUE_URL" --receipt-handle "$HANDLE"
                fi
              done
          env:
            - name: QUEUE_URL
              value: ${QUEUE_URL}
            - name: AWS_REGION
              value: ${AWS_REGION}
            - name: WORK_SECONDS
              value: "5"
          resources:
            requests:
              cpu: 500m
              memory: 128Mi
TriggerAuthentication e ScaledObject
Dois objetos do KEDA ligam a fila ao deployment. A TriggerAuthentication diz como autenticar: provider aws, sem roleArn, ou seja, com as credenciais do próprio operator. O ScaledObject diz o que escalar e por qual métrica:
apiVersion: keda.sh/v1alpha1
kind: TriggerAuthentication
metadata:
  name: aws-pod-identity
  namespace: jobs
spec:
  podIdentity:
    provider: aws
---
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: worker
  namespace: jobs
spec:
  scaleTargetRef:
    name: worker
  minReplicaCount: 0   # fila vazia = nenhum pod
  maxReplicaCount: 20
  pollingInterval: 15  # segundos entre leituras da fila
  cooldownPeriod: 120  # espera depois da última mensagem antes de ir a zero
  triggers:
    - type: aws-sqs-queue
      authenticationRef:
        name: aws-pod-identity
      metadata:
        queueURL: ${QUEUE_URL}
        queueLength: "10"        # mensagens por pod
        activationQueueLength: "0"
        awsRegion: ${AWS_REGION}
O queueLength é a meta por pod. Com 1.000 mensagens e meta 10, o cálculo pede 100 réplicas, e o maxReplicaCount segura em 20. Por padrão, o scaler também conta as mensagens em processamento (scaleOnInFlight: true), o que evita derrubar pods que ainda estão trabalhando.
Os manifestos usam variáveis preenchidas com envsubst a partir dos outputs do Terraform. Liste as variáveis no comando: sem a lista, o envsubst também apagaria o $MSG e o $HANDLE do script do consumidor.
export CLUSTER_NAME=eks-blog-castilho AWS_REGION=us-east-1
export QUEUE_URL=$(terraform output -raw jobs_queue_url)

envsubst '$CLUSTER_NAME' < k8s/karpenter.yaml | kubectl apply -f -
envsubst '$QUEUE_URL $AWS_REGION' < k8s/worker.yaml | kubectl apply -f -
envsubst '$QUEUE_URL $AWS_REGION' < k8s/keda.yaml | kubectl apply -f -
terraform apply e o cluster no ar
terraform init
terraform plan  -var 'public_access_cidrs=["SEU_IP/32"]'   # 60 recursos
terraform apply -var 'public_access_cidrs=["SEU_IP/32"]'

aws eks update-kubeconfig --region us-east-1 --name eks-blog-castilho
O plan fecha em 60 recursos: os 51 do cluster com Karpenter e mais 9 novos (as duas filas, o chart do KEDA e as duas roles com política e associação). O apply levou 13 minutos e meio, quase todo gasto no control plane e no node group.
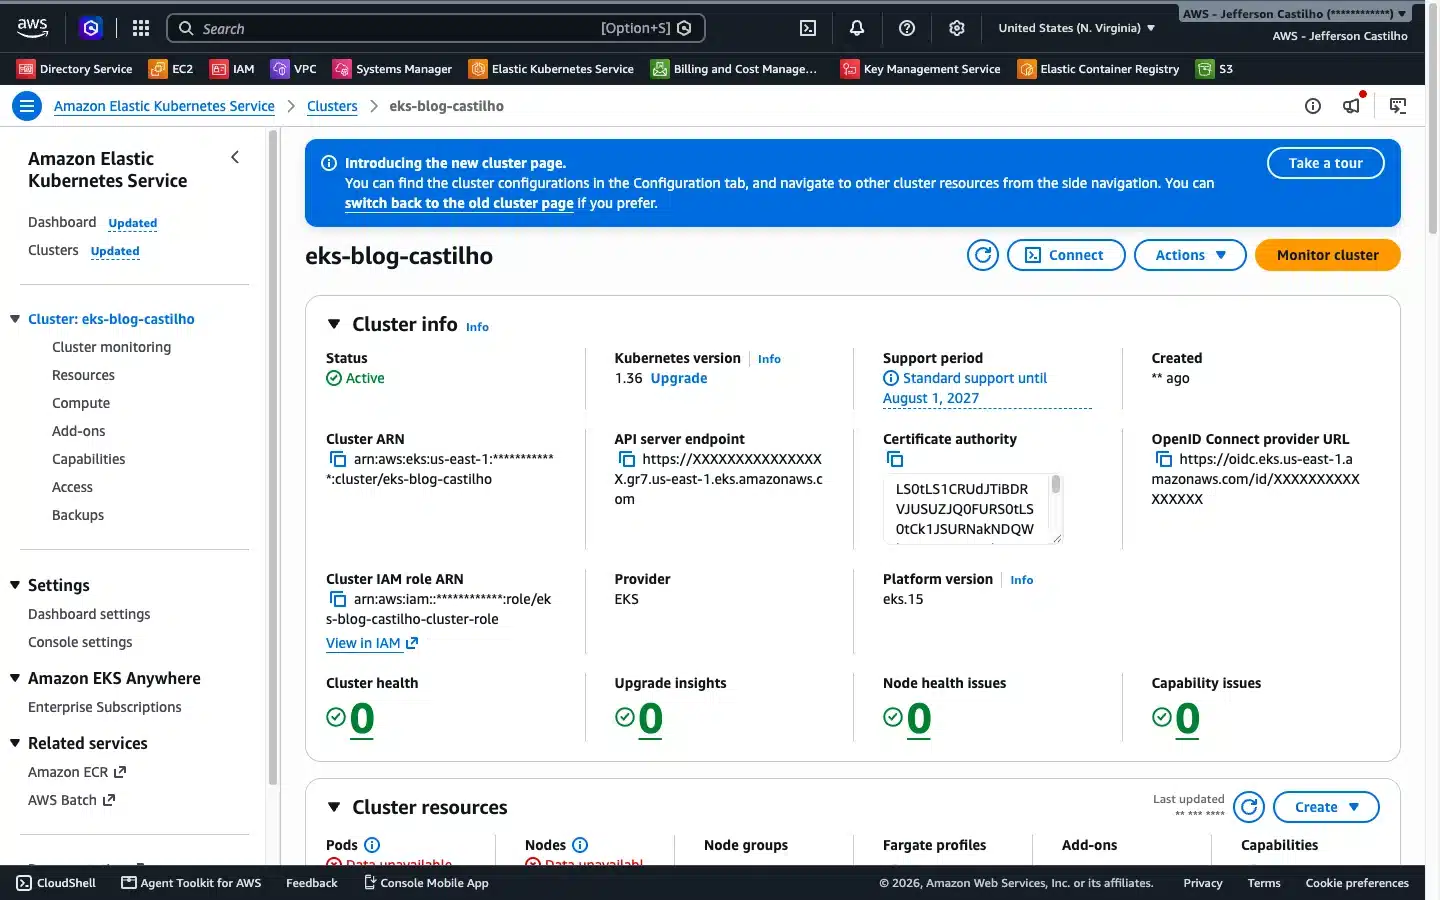
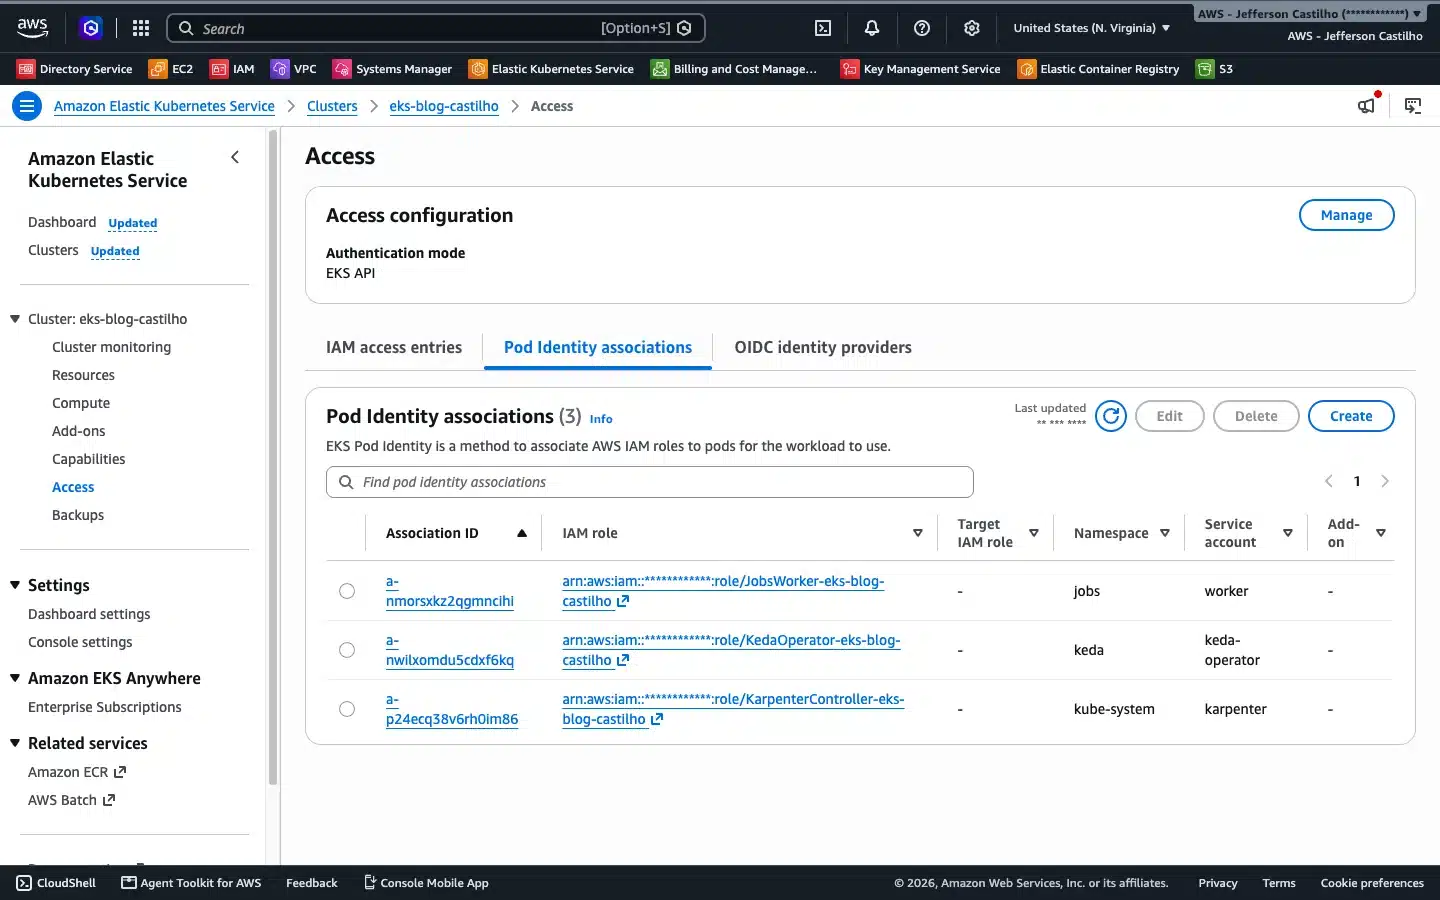
Logo depois do apply, o keda-operator aparece com uma reinicialização. É esperado: na primeira subida, ele gera os certificados do webhook e se reinicia de propósito. O log diz isso com todas as letras: Secrets have been updated; exiting so pod can be restarted.
Com os manifestos aplicados e a fila vazia, o ScaledObject fica READY=True e ACTIVE=False, e o KEDA cria o HPA keda-hpa-worker. Sem erro de credencial no log do operator, a leitura da fila pelo Pod Identity está funcionando:
kubectl get scaledobject,hpa -n jobs

NAME                          MIN   MAX   READY   ACTIVE   TRIGGERS        AUTHENTICATIONS
scaledobject.keda.sh/worker   0     20    True    False    aws-sqs-queue   aws-pod-identity

NAME                                                  TARGETS              MINPODS   MAXPODS   REPLICAS
horizontalpodautoscaler.autoscaling/keda-hpa-worker   <unknown>/10 (avg)   1         20        0
Testando a escala com 1.000 mensagens
O teste envia 1.000 mensagens com SendMessageBatch, em lotes de 10. Um segundo script grava, a cada 10 segundos, a profundidade da fila, as réplicas, os pods pendentes e os nós do Karpenter. Os dois estão no repositório, na pasta do artigo.
./monitorar.sh > linha-do-tempo.csv &
./enviar-mensagens.sh 1000

kubectl get scaledobject,hpa,pods -n jobs -w
kubectl get nodes -l karpenter.sh/nodepool=default \
  -L karpenter.sh/capacity-type,node.kubernetes.io/instance-type
O fluxo abaixo resume o que aconteceu, com os tempos reais contados a partir do início do envio:
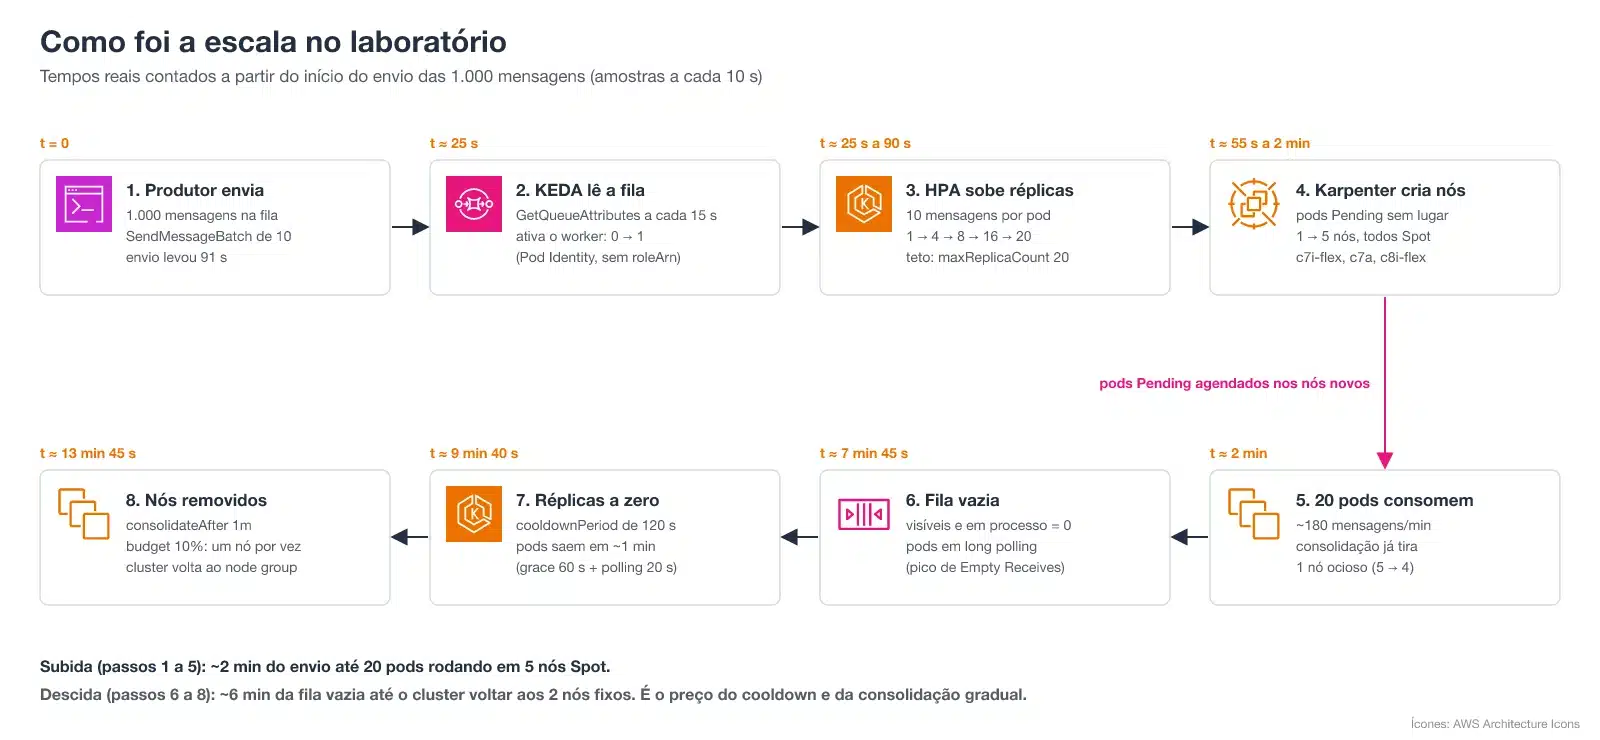
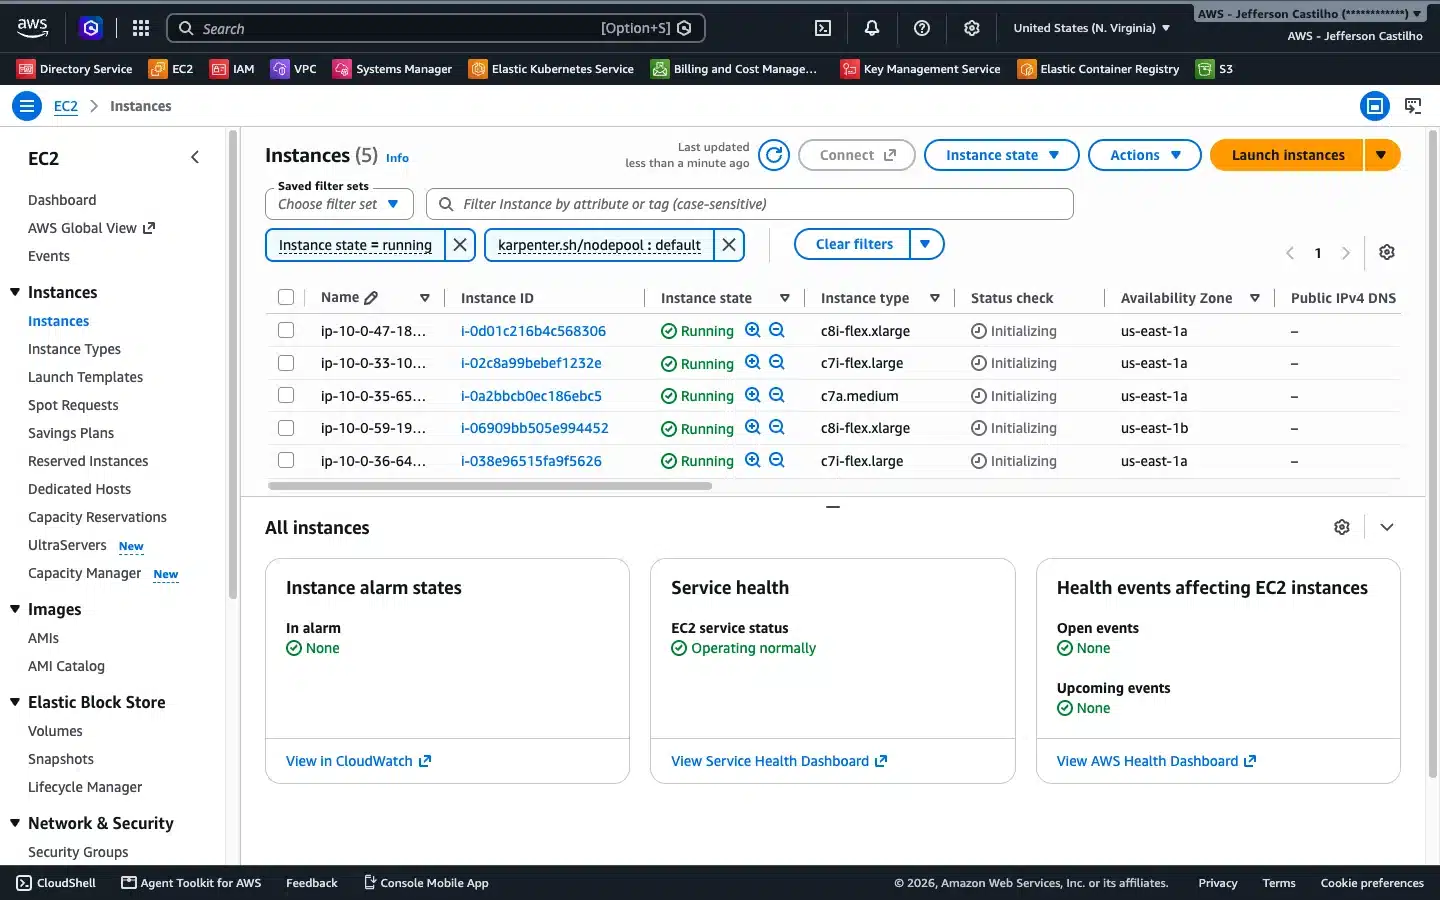
Em cerca de 25 segundos, o KEDA viu a fila e ligou o primeiro pod. Em menos de dois minutos, eram 20 pods rodando. Para caber todos, o Karpenter criou 5 nós, todos Spot, de três tipos diferentes. Ele escolheu cada instância pelo que os pods pendentes pediam, e não por uma lista fixa:
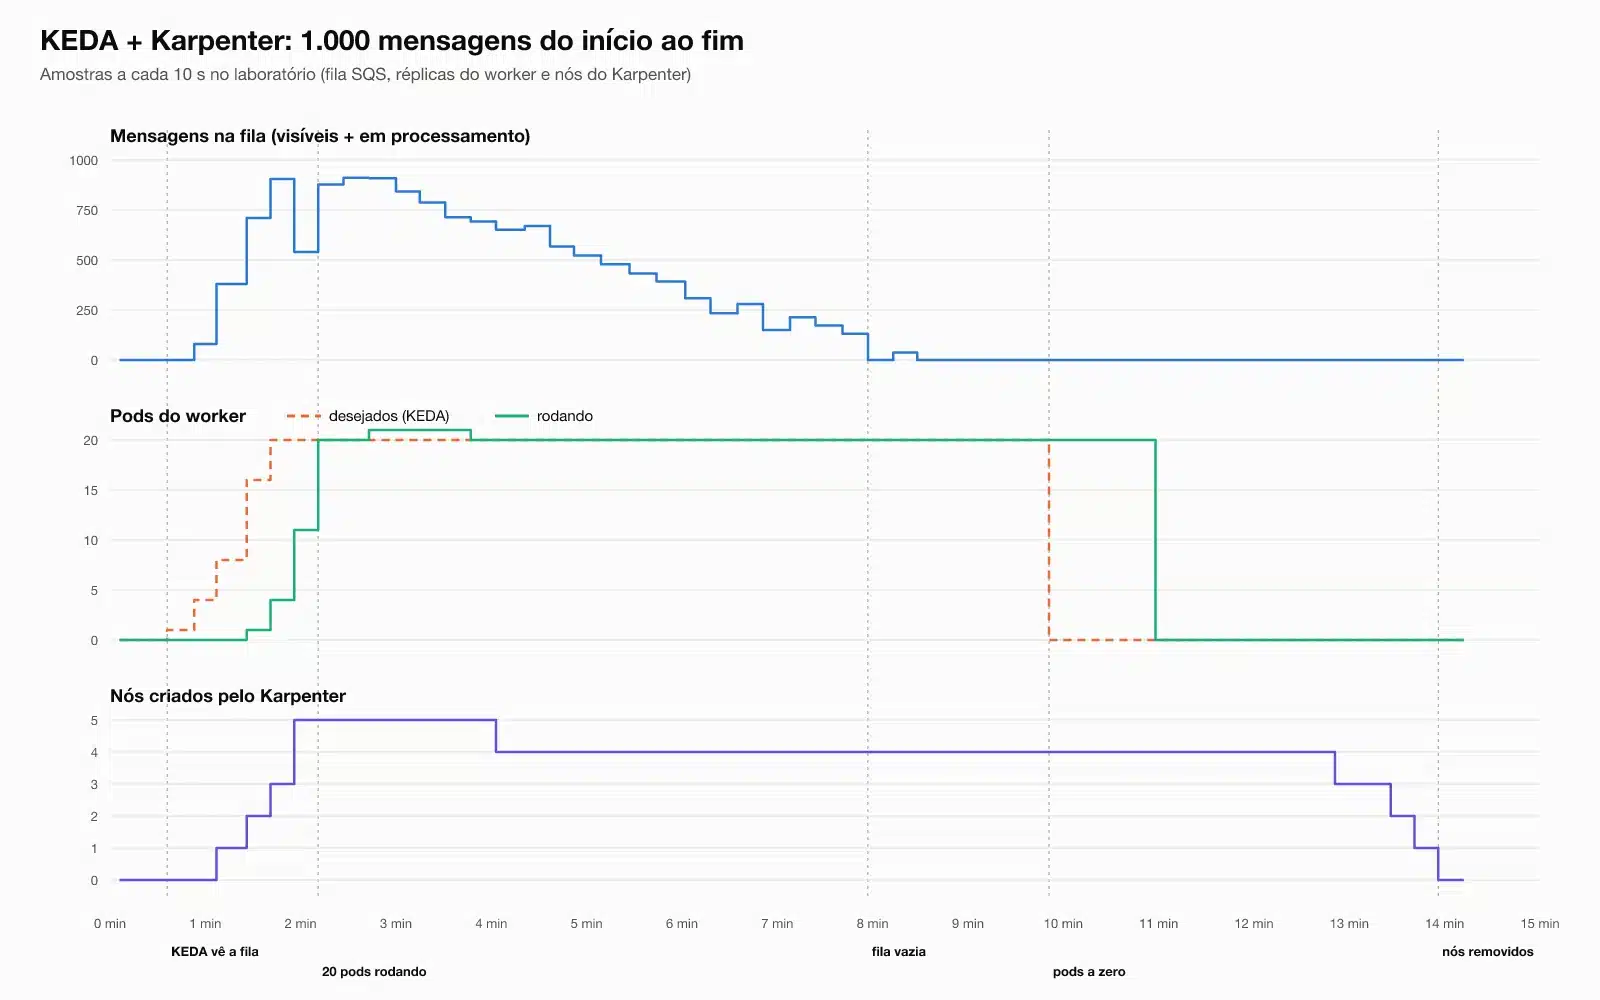
Com 20 pods, a fila caiu num ritmo de cerca de 180 mensagens por minuto. O gráfico tem a linha do tempo completa, com as amostras do script:
O CloudWatch da fila conta a mesma história. As mensagens visíveis sobem até 901 e caem a zero, enquanto as apagadas ficam em torno de 180 por minuto:
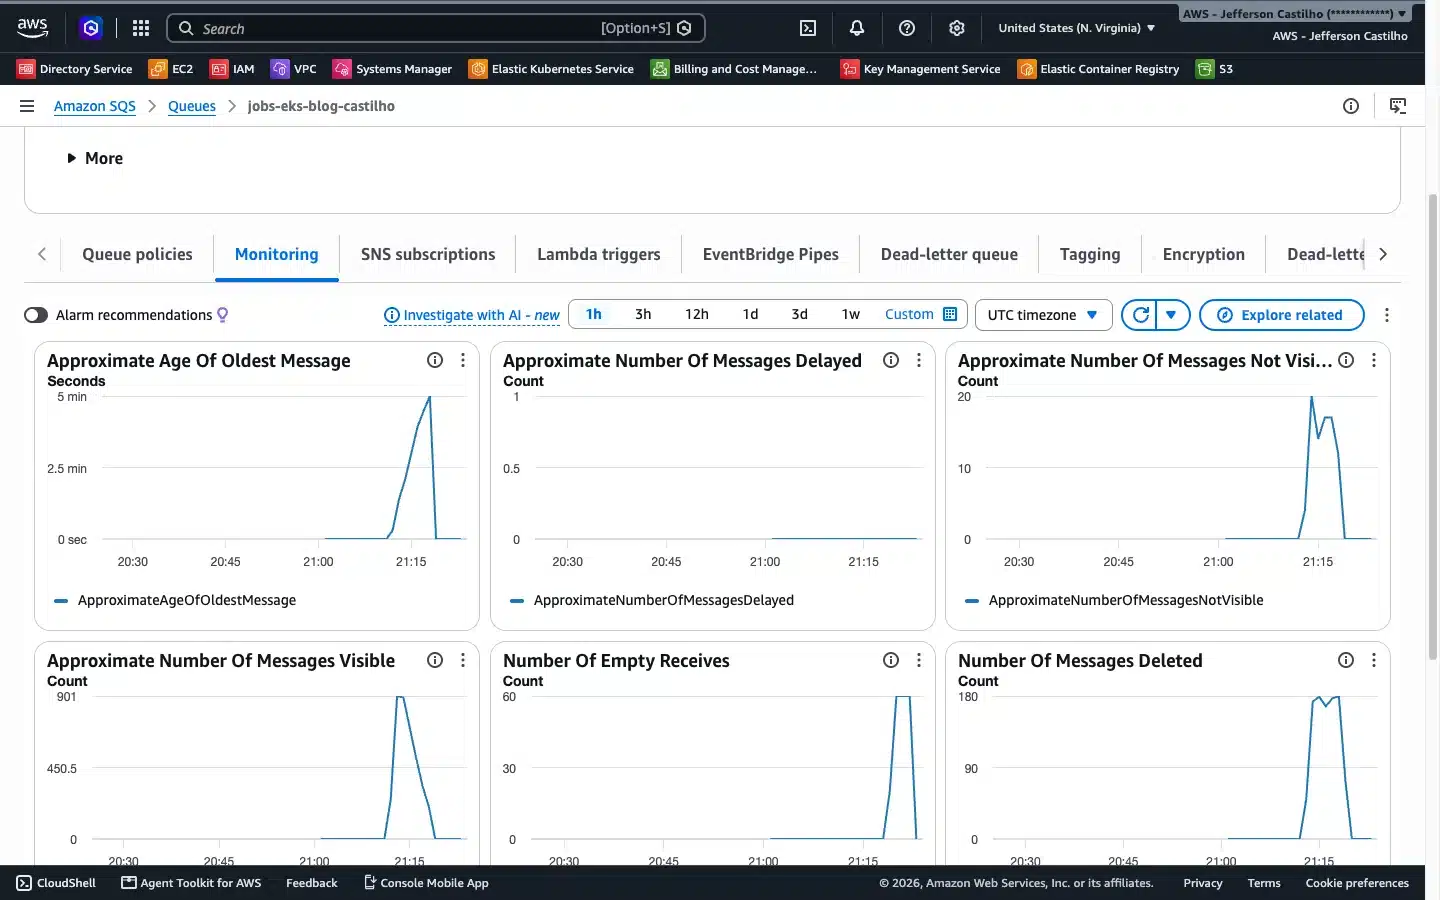
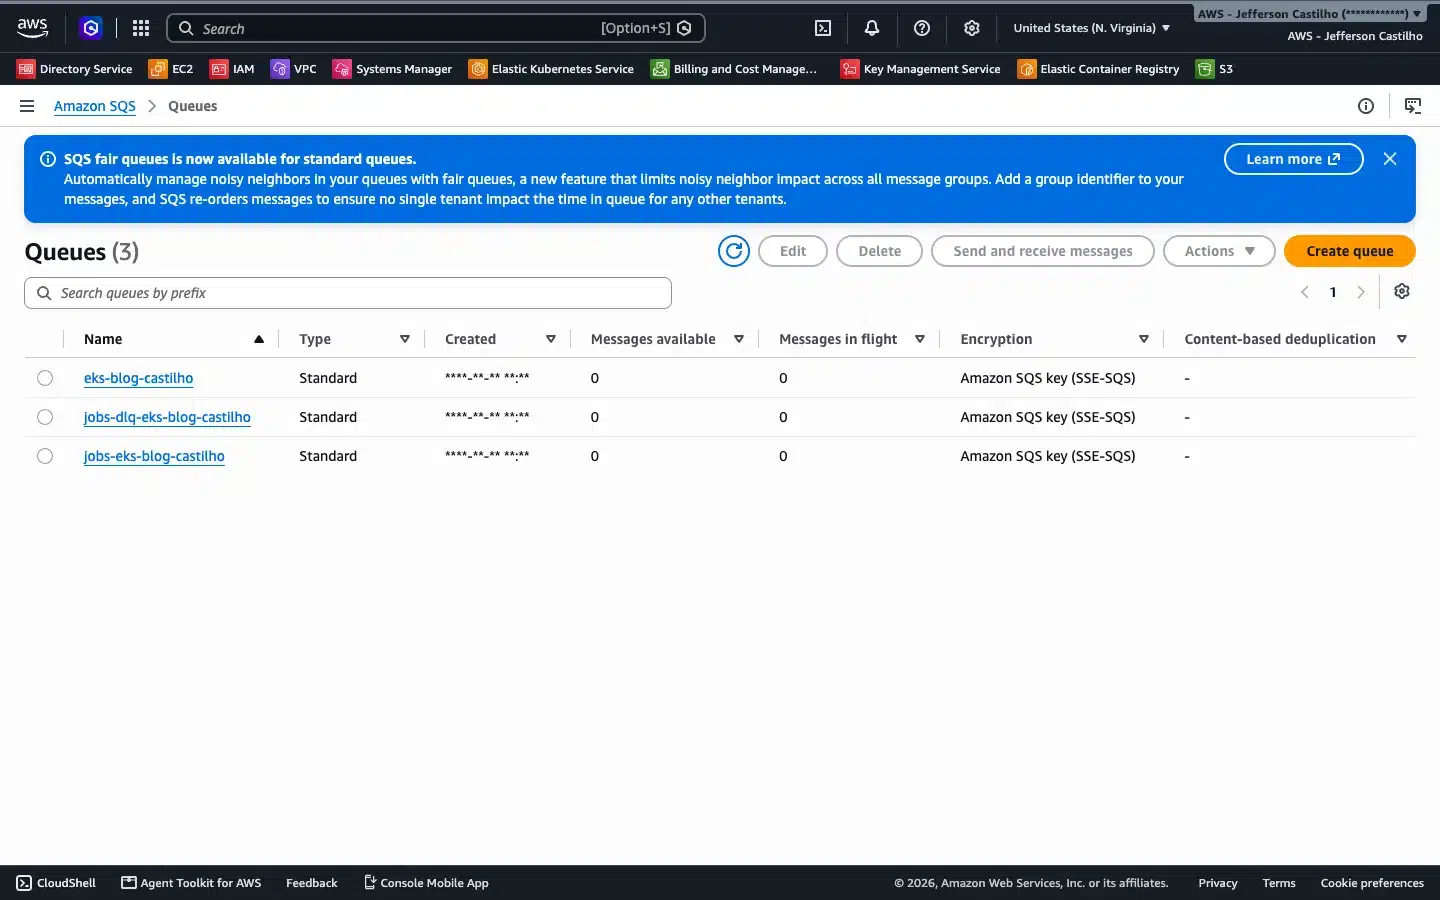
A fila zerou cerca de 7 minutos e 45 segundos depois do início. Dois minutos depois, passado o cooldownPeriod, o KEDA levou as réplicas a zero. Os nós saíram um por um, e o cluster voltou aos dois nós fixos perto dos 14 minutos. No fim, as três filas do laboratório estavam vazias:
O que o laboratório ensinou
- A descida é mais lenta que a subida, e de propósito. A subida levou 2 minutos. A descida levou 6: 2 de cooldown, 1 de saída dos pods e 3 de consolidação. Encurtar o
cooldownPeriodeconomiza nós, mas aumenta o risco de desligar tudo entre duas rajadas de mensagens. - Pod “a zero” não sai na hora. Depois que o KEDA pediu zero réplicas, os pods continuaram rodando por cerca de 1 minuto. É o
terminationGracePeriodSeconds: 60somado ao long polling de 20 segundos: o pod termina a mensagem atual antes de sair. Bom para não perder trabalho; ajuste o grace ao tempo real de processamento. - Leitura vazia também é cobrada. No cooldown, os 20 pods ficaram em long polling numa fila vazia, e o CloudWatch mostrou um pico de NumberOfEmptyReceives. Cada uma dessas chamadas é uma requisição do SQS. O long polling de 20 segundos já reduz bastante; sem ele, o pico seria muito maior.
- Visibilidade maior que o processamento. A mensagem some da fila por 60 segundos depois de recebida. Se o processamento passar disso, ela reaparece e outro pod a pega de novo. A regra é visibilidade maior que o tempo máximo de processamento, com folga.
- O Karpenter não espera a fila esvaziar para consolidar. Com a fila ainda cheia, ele tirou um nó que tinha sobrado subutilizado (5 para 4). Com o budget de 10%, os nós saíram um de cada vez no fim.
- Limite no NodePool. O
maxReplicaCountlimita os pods, e olimits.cpudo NodePool limita os nós. Use os dois. Sem eles, uma fila que cresce sem parar vira uma conta que cresce sem parar.
Custos e limpeza
- KEDA: sem custo próprio; os pods dele rodam no node group fixo.
- SQS: cobrado por requisição, incluindo as leituras vazias. No teste, ficou em centavos.
- Nós do Karpenter: só existem enquanto há trabalho. No teste, 5 instâncias Spot por cerca de 12 minutos.
- Cluster base: control plane, NAT Gateway e os dois nós fixos, como no primeiro artigo da série. É a maior parte da conta do laboratório.
Na limpeza, apague primeiro os objetos do Kubernetes e espere o Karpenter devolver os nós. Só depois rode o destroy, para não deixar instância órfã fora do controle do Terraform:
kubectl delete scaledobject worker -n jobs
kubectl delete triggerauthentication aws-pod-identity -n jobs
kubectl delete deployment worker -n jobs
kubectl delete nodepool default
kubectl delete ec2nodeclass default
kubectl get nodeclaims            # espere a lista ficar vazia

terraform destroy -var 'public_access_cidrs=["SEU_IP/32"]'

# confira se sobrou instância do Karpenter
aws ec2 describe-instances \
  --filters Name=tag:karpenter.sh/nodepool,Values=default Name=instance-state-name,Values=running \
  --query 'Reservations[].Instances[].InstanceId' --output text
Conclusão
O KEDA no EKS fecha o ciclo que o Karpenter começou. O Karpenter escala os nós, o KEDA escala os pods, e a fila decide os dois. Com scale-to-zero, um consumidor que fica parado a maior parte do dia não ocupa nó nenhum enquanto não há trabalho.
O ponto que mais merece atenção não é o Terraform, que se resume a um chart e uma role. É acertar os tempos: queueLength, cooldownPeriod, visibilidade da mensagem e grace period do pod precisam conversar entre si. No próximo artigo da série, o KEDA escala uma aplicação HTTP pelas requisições que chegam ao ALB, e não por fila.
Referências oficiais
- Scaling Deployments — KEDA
- AWS SQS Queue scaler — KEDA
- AWS authentication provider — KEDA
- Cluster compatibility — KEDA
- Release v2.21.0 — KEDA
- EKS Pod Identity — Amazon EKS
- Visibility timeout — Amazon SQS
- Amazon SQS pricing
Interessado em saber mais sobre artigos relacionados a Amazon EKS CLIQUE AQUI
🚀 Vamos nos conectar?
Não perca nenhuma oportunidade! Cadastre-se nas minhas redes e no canal do YouTube para receber conteúdos de TI, Cloud, Azure, AWS, Kubernetes e DevOps em primeira mão.
Dica: no Facebook, todos os artigos do blog são publicados automaticamente. Vale a pena curtir!
💬 Dúvidas ou problemas?
Com o intuito de ajudar a comunidade, caso você tenha dúvidas ou encontre problemas na execução dos comandos deste artigo, deixe um comentário abaixo. Responderei o mais breve possível!
Muito obrigado pela visita e até o próximo post!
Jefferson Castilho Especialista em Cloud & DevOps.Este guia técnico é exclusivo do Blog do Castilho. Explore mais conteúdos sobre Cloud e DevOps.